

Представьте типичный тест на 60 вопросов для найма разработчика. Сильный кандидат первые сорок минут отвечает на вопросы, которые для него очевидны, — скучает, теряет мотивацию, а часть просто бросает тест на середине. Слабый кандидат, наоборот, с десятого вопроса упирается в задачи не своего уровня и дальше в основном угадывает. В обоих случаях большая часть вопросов не дала никакой информации: мы и так уже понимали уровень, но продолжали спрашивать.
Фиксированный тест — это компромисс, рассчитанный на «среднего» кандидата, которого не существует. Отсюда три хронические проблемы: длинные тесты дают высокий процент незавершённых сессий, короткие — низкую точность, а одинаковый набор вопросов для всех означает, что половина ответов предсказуема заранее и не уточняет оценку.
Адаптивное тестирование решает это иначе: следующий вопрос выбирается на основе уже данных ответов. В этой статье разберём, как устроен адаптивный движок в Codenrock Vibe, какие в нём есть стратегии, и — самое практичное — как подготовить банк вопросов, чтобы адаптивность действительно работала.
- Что такое адаптивное тестирование
- Как работает цикл: от ответа к ответу
- Четыре стратегии адаптации
- Сбалансированная (стратегия по умолчанию)
- Углубленная проверка
- Быстрая оценка
- Адаптивная сложность
- Как выбрать: задача → стратегия
- Глубина теста и банк вопросов
- Сколько вопросов должно быть в банке
- Что система проверяет перед запуском
- Откуда берутся вопросы
- Чек-лист внедрения
- Заключение
Что такое адаптивное тестирование
Идея не новая. Классический подход — CAT (Computerized Adaptive Testing) на базе IRT (Item Response Theory, теория ответов на задания) — используется, например, в американском экзамене для медсестёр NCLEX с 1994 года и в сертификациях ISC2. Схема такая: у каждого вопроса есть статистически откалиброванные параметры (сложность, способность различать сильных и слабых, вероятность угадывания), способность кандидата описывается одним числом, а следующий вопрос выбирается по математическому критерию — какой вопрос даст максимум информации об уровне именно этого человека. Тест останавливается, когда погрешность оценки становится достаточно малой. Результат: сокращение теста примерно вдвое при той же точности.
У классики есть цена. Чтобы откалибровать один вопрос, нужно 200–500 реальных ответов на него — то есть новые вопросы нельзя вводить без длительного пилотирования. Банк должен быть большим: от 300+ вопросов для полноценного CAT. Оценка одномерна — если компетенций несколько, модель заметно усложняется. И главное для HR: решение «почему задан именно этот вопрос» объясняется только формулой.
В Codenrock Vibe используется другой подход: решение о следующем вопросе принимает языковая модель (LLM), которая видит полный контекст сессии — покрытие каждой компетенции, сложность уже пройденных вопросов, последние ответы, выбранную стратегию и глубину теста. Формула подхода из нашего практического гайда:
Адаптивное тестирование = банк проверенных вопросов + выбранная стратегия + анализ ответов кандидата + контролируемый AI-выбор следующего вопроса.
Ключевое слово — «контролируемый». LLM работает в жёстких рамках, которые обеспечивает обычный детерминированный код: выбор только из заранее подготовленного банка, никаких сочинённых на ходу вопросов, никаких повторов, обязательные минимум и максимум длины теста. AI не принимает кадровых решений — он только строит маршрут по банку.
Чем это отличается от классического CAT на практике:
- Работает «с нуля». Не нужна статистическая калибровка на сотнях ответов — сложность задаётся при создании вопроса и проверяется на этапе генерации. Банк можно собрать и запустить за дни, а не за месяцы пилотирования.
- Многомерность. Система оценивает не один общий балл, а профиль по каждой компетенции — и решает сразу, какую компетенцию проверить следующей и вопросом какой сложности.
- Объяснимость. По каждому шагу сохраняется словесное обоснование: почему выбран этот вопрос, почему тест продолжен или завершён. HR и технический эксперт видят логику маршрута, а не только итоговую цифру.
Честная оговорка: на больших, годами откалиброванных банках классический CAT статистически строже — у него есть математические гарантии сходимости оценки. LLM-подход выигрывает там, где банк новый или часто меняется, компетенций много, а интерпретируемость маршрута важна для людей, принимающих решение.
Как работает цикл: от ответа к ответу

После каждого ответа кандидата происходит следующее.
1. Оценка ответа. Вопросы с выбором вариантов проверяются автоматически. Открытые ответы и код оценивает AI: фиксируется вердикт «верно/неверно» и балл от 0 до 100.
2. Обновление картины. Пересчитывается статистика по всем компетенциям: сколько вопросов задано по каждой, какая доля правильных, какая средняя сложность. Ответы, которые ещё не успели пройти оценку, честно исключаются из статистики целиком — они не считаются ни правильными, ни неправильными.
3. Жёсткие проверки до всякого AI. Если достигнут максимум вопросов — тест завершается, LLM даже не вызывается. Если в банке не осталось незаданных вопросов — тоже.
4. Решение LLM. Модель получает: выбранную стратегию и её текущую фазу, прогресс, сводку по компетенциям (включая предупреждение о перекосе покрытия), последние ответы кандидата и весь банк с пометками «задан/не задан». Она возвращает решение — продолжить или остановиться, — выбранный вопрос и словесное обоснование.
5. Проверка решения кодом. Здесь начинаются гарантии:
- Минимум неприкосновенен. Если LLM решила остановиться раньше минимальной длины теста, а незаданные вопросы есть — решение игнорируется, кандидат получает следующий вопрос. Это же защищает от случайного двойного нажатия «Ответить».
- Только из банка, без повторов. Если модель вернула идентификатор несуществующего вопроса, система повторяет запрос, а если корректный вопрос так и не получен — сама выбирает незаданный вопрос из банка уже без участия модели. Идентификатор уже заданного вопроса отбрасывается сразу: кандидату уходит следующий незаданный вопрос. Тест не завершается ошибочно из-за некорректного ответа модели.
- Кандидат не видит служебных данных. Правильные ответы, эталонные решения и критерии оценки вырезаются из вопроса перед отправкой. Кандидат видит только свой индивидуальный маршрут, а не весь банк.
6. Логирование. По каждому вопросу фиксируется: фаза теста, состояние кандидата до вопроса, причина выбора именно этого вопроса, причина продолжения. Это основа «прозрачного» отчёта — маршрут можно разобрать постфактум.
Движок сам прекращает выдачу вопросов тремя путями: достигнут максимум вопросов (гарантируется кодом — LLM не может продлить тест сверх лимита); исчерпан банк; либо LLM решила остановиться — и это решение принимается только после минимума. Кроме того, как и в любом тесте, действует общий лимит времени, а после набора минимума кандидат может завершить тест и сам. Ориентиры для остановки со стороны модели: достигнуто целевое число вопросов и по каждой компетенции есть хотя бы 2 вопроса; последние ответы не выявляют новых слабых мест; уровень стабильно подтверждён.
Важно для сравнения кандидатов: маршруты у всех разные, но модель компетенций и стратегия — одни. Итоговая оценка строится по фактически заданным вопросам, и если по какой-то компетенции вопросов оказалось больше — это сигнал, что система уточняла неопределённость, а не «предвзятость» теста.


Четыре стратегии адаптации
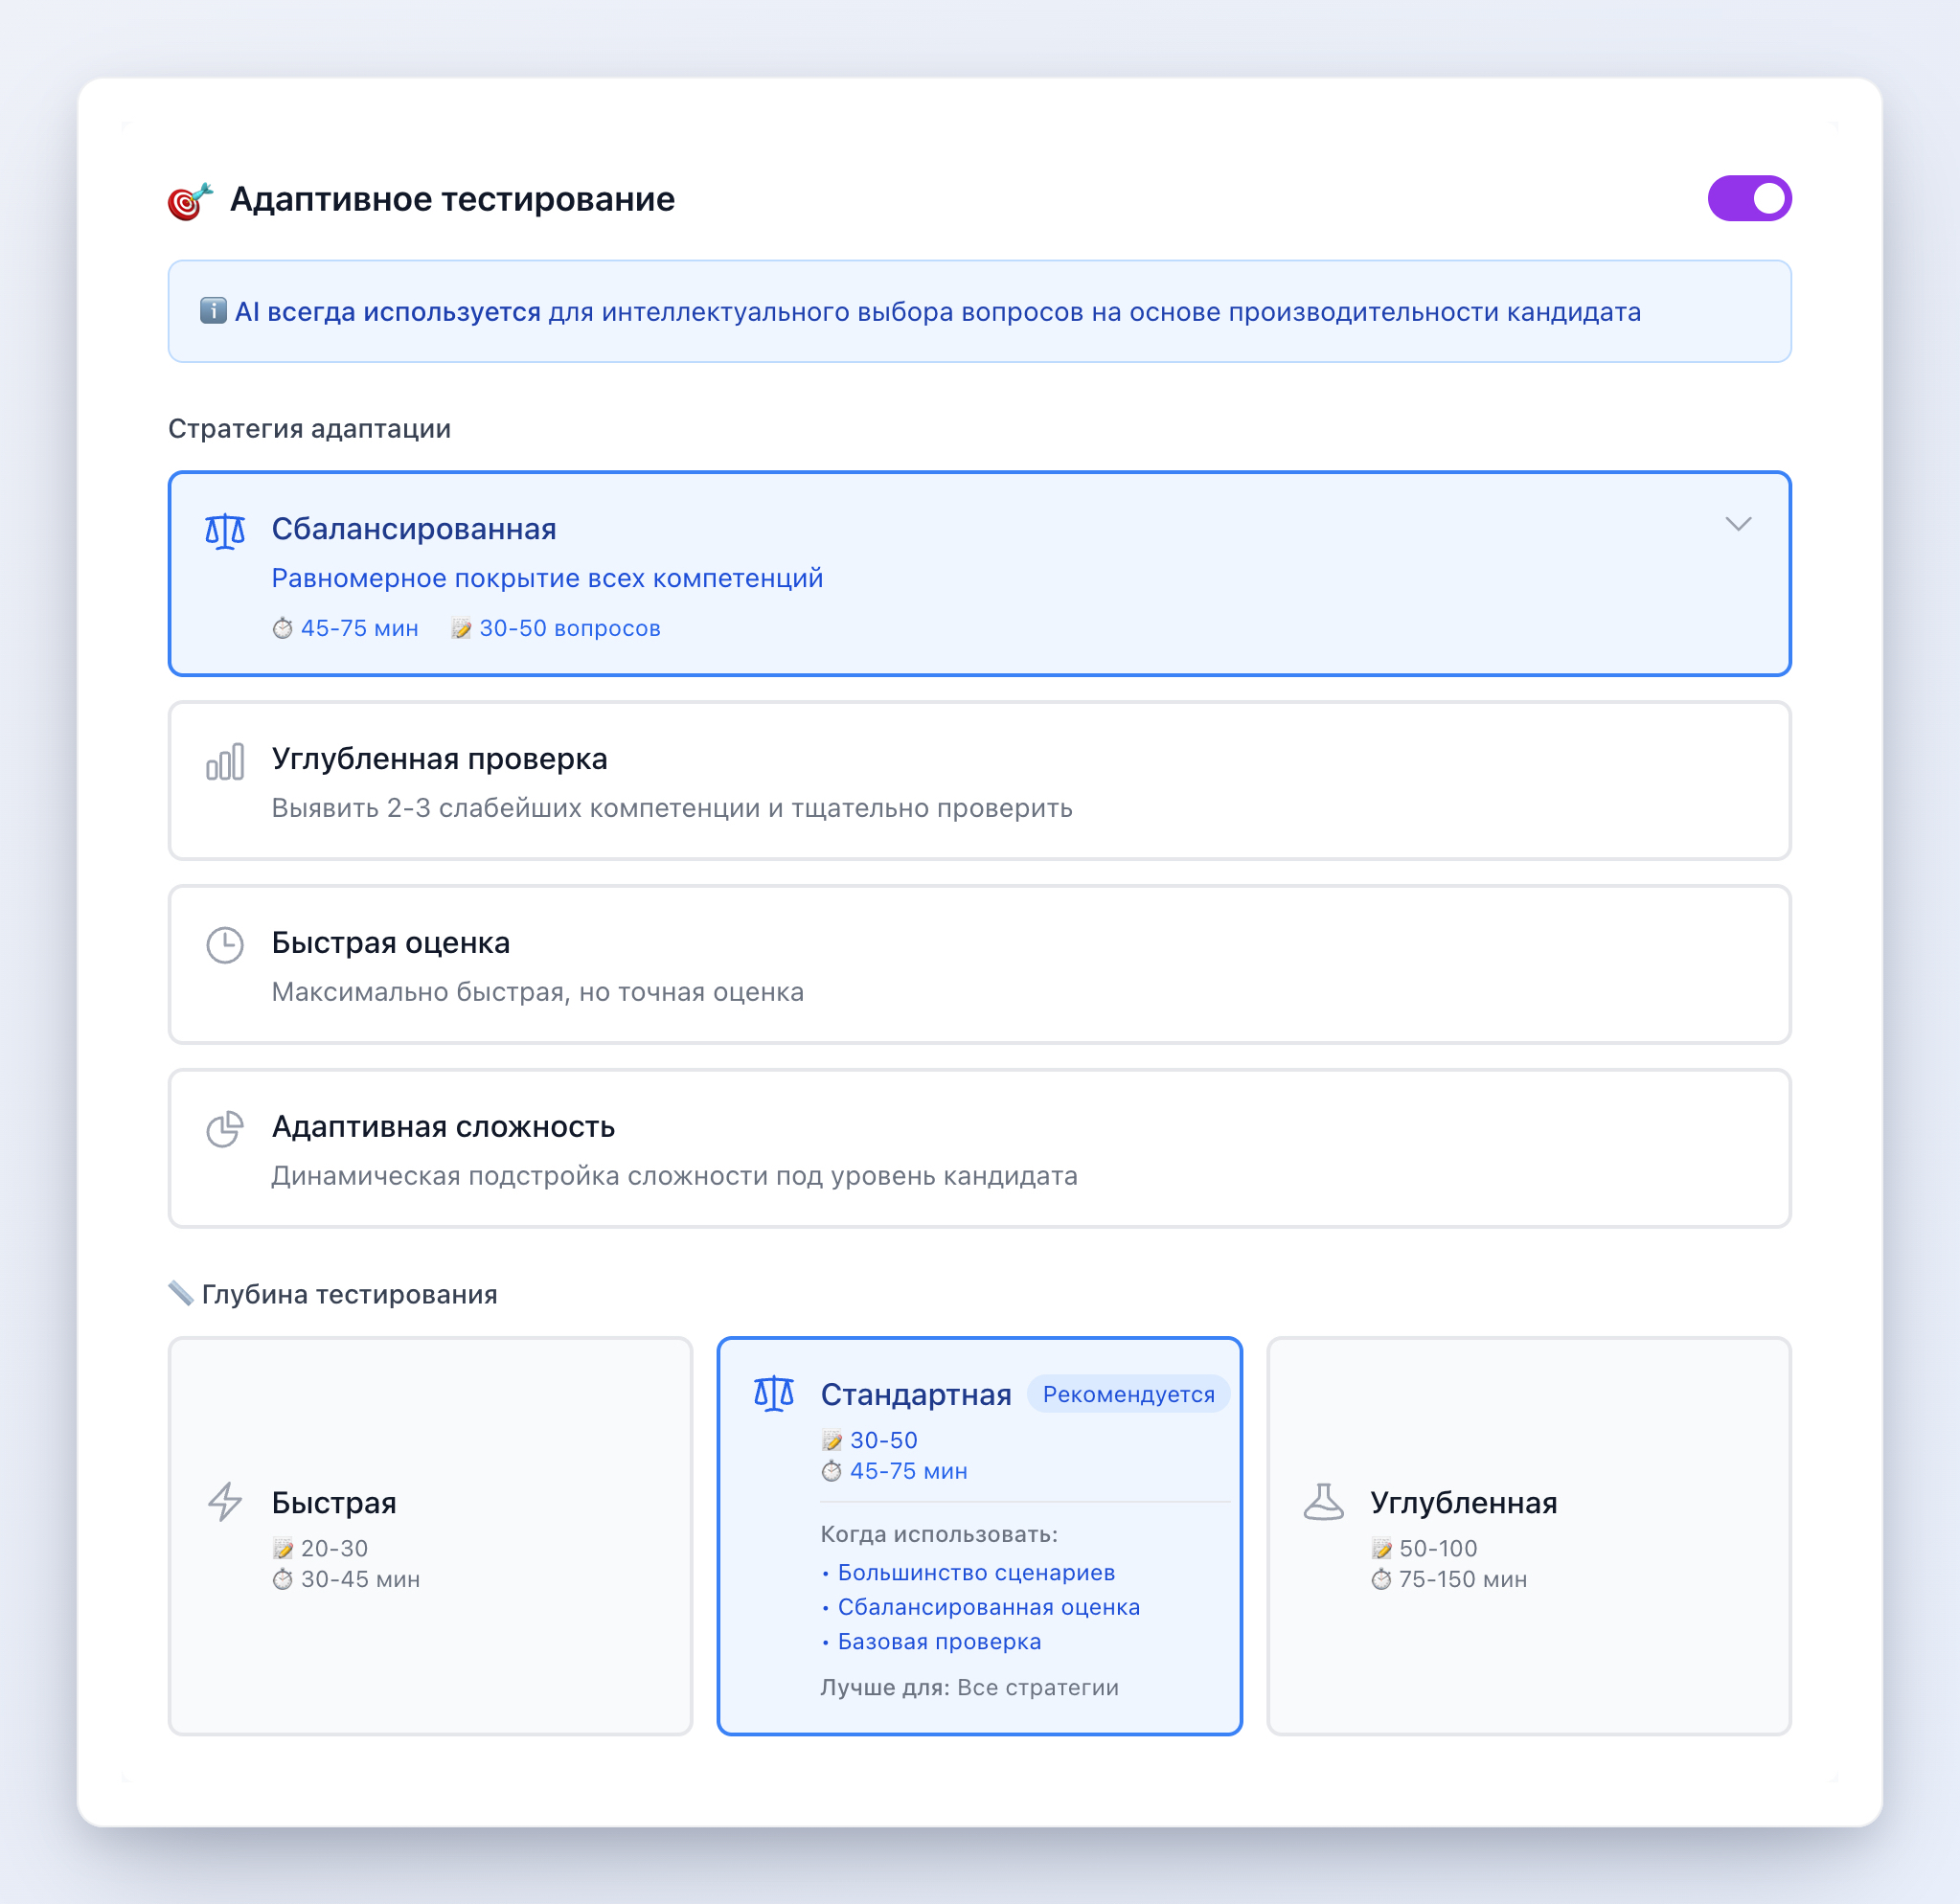
Стратегия отвечает на вопрос «что оптимизирует система»: баланс, слабые зоны, скорость или точность определения уровня. Каждая проходит три фазы; границы фаз считаются как доля от целевого числа вопросов.

Сбалансированная (стратегия по умолчанию)
Цель — ровный профиль по всем компетенциям без перекосов.
- Первичное покрытие (0–50% теста): минимум 2 вопроса на каждую компетенцию.
- Адаптивное заполнение (50–85%): добираются компетенции с меньшим числом вопросов, сложность подстраивается под ответы.
- Финальное выравнивание (85%+): покрытие всех компетенций выравнивается, чтобы подтвердить итоговую оценку.
Когда выбирать: первичный отбор, сравнение нескольких кандидатов на одну роль, любой типовой найм, где нужен полный профиль. Если сомневаетесь — начинайте с неё.
Углубленная проверка
Цель — достоверно локализовать слабые места.
- Сканирование (0–35%): быстрая оценка всех компетенций, поиск проблемных зон.
- Погружение (35–85%): интенсивная проверка 2–3 самых слабых компетенций — больше вопросов, вариация сложности; минимальное покрытие остальных сохраняется.
- Верификация (85%+): повторная проверка изначально провальных зон — случайность или закономерность?
Обратите внимание: фаза погружения начинается уже с 35% теста — раньше, чем основная фаза у Сбалансированной (50%) и Быстрой оценки (40%), — и занимает половину теста: стратегия быстро переходит от сканирования к работе со слабыми зонами. Когда выбирать: оценка перед повышением, перевод на другую роль, построение индивидуального плана развития. Здесь нужен не общий балл, а ответ «где именно нужно развитие».
Быстрая оценка
Цель — максимум информации за минимум вопросов.
- Экспресс-скан (0–40%): обычно 1–2 вопроса средней сложности на компетенцию.
- Фокус (40–80%): прицельная проверка только тех зон, где осталась неопределённость; на очевидно сильные зоны вопросы не тратятся.
- Завершение (80%+): финальная верификация ключевых компетенций.
Когда выбирать: массовый скрининг, экспресс-оценка перед интервью. Обычно сочетается с глубиной «Быстрая». Меньшая длительность не означает более лёгкую оценку — просто уровень становится понятен быстрее.
Адаптивная сложность
Цель — точно определить уровень кандидата через управление сложностью.
- Калибровка (0–30%): установка базового уровня со средней сложности.
- Адаптация (30–70%): сложность растёт после уверенных ответов и снижается после ошибок; фокус на пограничных компетенциях.
- Подтверждение (70%+): прицельные вопросы для стабильного подтверждения уровня.
У этой стратегии самая длинная финальная фаза — треть теста уходит на подтверждение, чтобы вывод «это middle» опирался не на пару удачных ответов. Когда выбирать: грейдирование junior/middle/senior, роли с широким ожидаемым разбросом навыков.
Как выбрать: задача → стратегия
| Задача | Стратегия |
|---|---|
| Типовой найм, сравнение кандидатов на одну роль | Сбалансированная |
| План развития, оценка перед повышением, критичные позиции | Углубленная проверка |
| Массовый скрининг, экспресс-оценка перед интервью | Быстрая оценка |
| Определение грейда (junior/middle/senior) | Адаптивная сложность |

Глубина теста и банк вопросов
Стратегия определяет, что оптимизирует система; глубина — сколько данных она должна собрать. Три пресета:
| Глубина | Минимум | Целевое | Максимум | Ориентир по времени |
|---|---|---|---|---|
| Быстрая | 20 | 25 | 30 | ~30–45 мин |
| Стандартная (рекомендуемая) | 30 | 40 | 50 | ~45–75 мин |
| Углубленная | 50 | 75 | 100 | ~75–150 мин |
Есть и произвольный режим со своими min/target/max. Семантика: раньше минимума тест завершить нельзя (кнопка «Завершить тест» до минимума просто выдаёт следующий вопрос); целевое число — ориентир для остановки; максимум — жёсткий потолок. Фактическая длина плавает внутри диапазона: если картина ясна, тест закончится ближе к целевому числу, при неопределённости — дотянется к максимуму.

Сколько вопросов должно быть в банке
Это самый частый практический вопрос, и здесь важно понимать поведение системы: при недостаточном банке она не блокирует запуск, а молча укорачивает тест. Если банк меньше максимума пресета, потолок сжимается до размера банка; если банк меньше даже минимума — тест сожмётся до 50–100% от того, что есть. То есть формально «Углубленная» глубина с банком в 40 вопросов запустится — но по факту это будет короткий тест, и заявленной глубины вы не получите.
Отсюда правило номер один: чтобы пресет отработал в полную силу, банк профессии должен быть не меньше максимума пресета — 30 вопросов для Быстрой, 50 для Стандартной, 100 для Углубленной.
Дальше — рекомендации из практики (это уже не жёсткие пороги системы, а гигиена банка):
- Запас в 1,5–2 раза сверх максимума. Адаптивный выбор — это выбор из ещё не заданных вопросов. Если банк равен максимуму впритык, к концу теста «выбор» вырождается в «берём что осталось». Для Стандартной глубины это означает банк ~50–100 вопросов, для Углубленной — ~100–200.
- 5–7 компетенций на профессию. Больше — тест размазывается, на каждую компетенцию не хватает вопросов для уверенного вывода. При 5–7 компетенциях и Стандартной глубине получается ~10–15 вопросов на компетенцию в банке, при Углубленной — ~20–30.
- Равномерность по компетенциям. Все стратегии в первой фазе обходят все компетенции — банку нужен сопоставимый объём в каждой, а не 90% вопросов в одной. Компетенция, важная для роли, но представленная двумя вопросами, — типичная ошибка.

- Покрытие всех уровней сложности. Шкала сложности — от 1 (базовый) до 4 (экспертный), и в каждой компетенции должны физически существовать и лёгкие, и сложные вопросы. Стратегия «Адаптивная сложность» без этого просто не сможет повышать и понижать планку. Важно: перед запуском система это не проверяет — распределение по сложности целиком на совести автора банка.
- Разнообразие типов. Доступны четыре типа: один правильный вариант, несколько правильных вариантов, открытый ответ, задача с кодом. Вопросы с выбором дешевле проверять и быстрее проходить; открытые и код дают глубину. Разумная смесь работает лучше, чем 100% «угадаек».

Пример. Скрининг 500 откликов на Junior Python: стратегия «Быстрая оценка» + глубина «Быстрая» (20–30 вопросов, ~30–45 минут). Банк — минимум 30 вопросов, комфортно 45–60, преимущественно вопросы с выбором вариантов плюс несколько коротких задач с кодом.
Другой пример. Ежегодная оценка команды из 20 инженеров под планы развития: «Углубленная проверка» + глубина «Углубленная» (50–100 вопросов). Банк от 100 вопросов, лучше 150–200, с полным покрытием сложностей 1–4 в каждой компетенции — иначе фаза погружения не сможет варьировать сложность в слабых зонах.
Что система проверяет перед запуском
Перед запуском система подсказывает о проблемах готовности банка:
- Блокер: пустой банк или роль, у которой суммарно меньше 5 вопросов по всем компетенциям.
- Блокер: шаблон оценки без вопросов (для адаптивного шаблона считается весь банк профессии).
- Предупреждение (не блокер): компетенции, у которых 0 вопросов.
Обратите внимание на разрыв между «формально запустится» и «будет работать хорошо»: 5 вопросов на роль — это порог видимости запуска, а не рекомендация. Проверок распределения по сложности и равномерности покрытия нет — эти пункты нужно контролировать самостоятельно, чек-лист ниже.
Ещё один нюанс: в банк для кандидата попадают только «живые» вопросы — прошедшие модерацию или не требовавшие её. Отклонённые модератором и находящиеся на перегенерации вопросы автоматически выпадают из пула, поэтому фактический размер банка может быть меньше, чем строк в списке вопросов. Сверяйтесь с числом действующих вопросов, а не с общим счётчиком.
Откуда берутся вопросы
Банк можно собрать тремя путями: написать вопросы вручную через интерфейс, импортировать свои готовые, либо сгенерировать встроенной AI-системой — по описанию компетенций она раскладывает каждую на подтемы и создаёт вопросы нужных типов и сложностей (до 50 вопросов на компетенцию за один запуск).

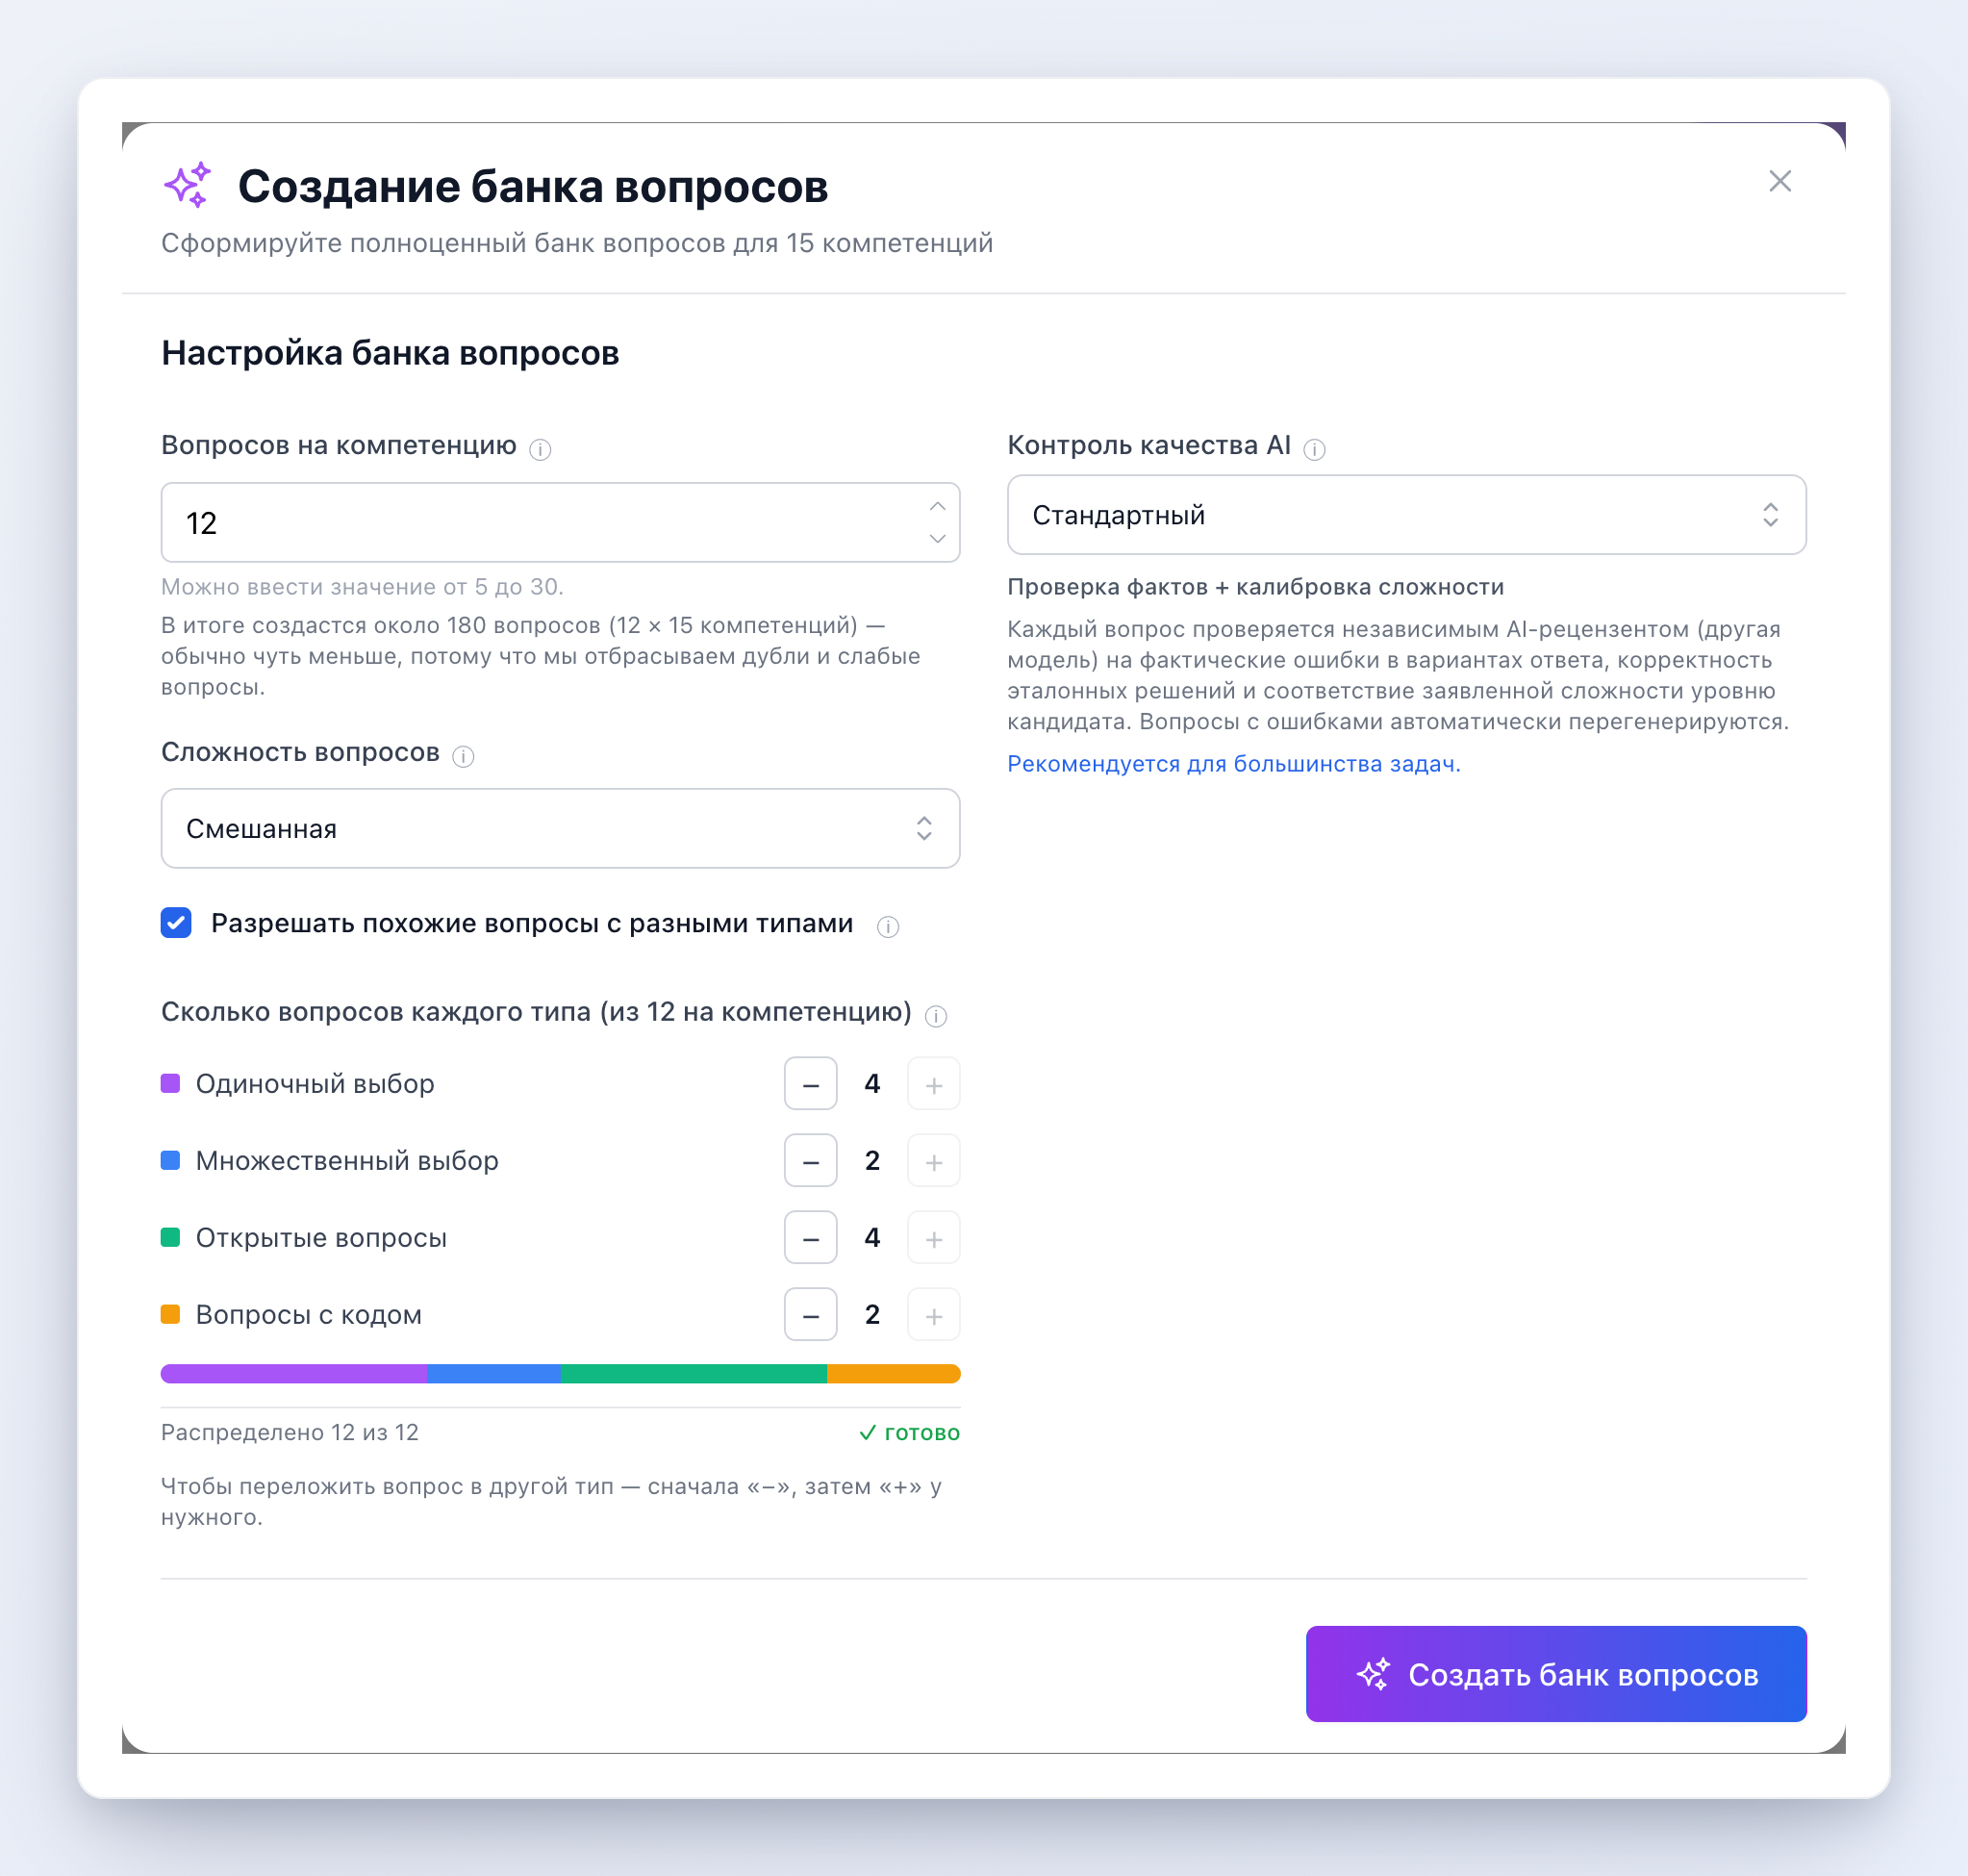
Сгенерированный вопрос — это не «сырой выход нейросети»: в стандартном режиме генерации каждый вопрос проходит многоэтапную автоматическую валидацию — проверку фактической корректности, калибровку заявленной сложности, контроль утечки ответа в формулировку и дедупликацию с уже существующим банком. Не прошедшие проверки вопросы переделываются или отбраковываются, а отклонения эксперта-человека учитываются при следующих генерациях. Подготовка теста «под ключ» по брифу, по нашему опыту, обычно занимает несколько рабочих дней, включая согласование компетенций и проверку качества.
Подробный разбор пайплайна генерации выйдет отдельной статьёй — «Как устроена AI-генерация вопросов в Codenrock Vibe»; ссылку добавим сюда после её публикации.
Чек-лист внедрения
Перед запуском адаптивного теста пройдитесь по списку:
- Компетенции. 5–7 на профессию, согласованы с техническим экспертом или нанимающим менеджером. Веса и приоритеты зафиксированы.
- Стратегия. Выбрана по таблице «задача → стратегия». По умолчанию — Сбалансированная.
- Глубина. Быстрая — скрининг, Стандартная — большинство сценариев, Углубленная — развитие и критичные роли.
- Объём банка. Не меньше максимума пресета (30 / 50 / 100), с запасом — в 1,5–2 раза больше.
- Равномерность. У каждой важной компетенции сопоставимое число вопросов; нет компетенций с 0–2 вопросами.
- Сложность. В каждой компетенции есть вопросы всех уровней от 1 до 4 — система это за вас не проверит.
- Типы вопросов. Смесь выбора вариантов, открытых ответов и кода — под специфику роли и бюджет времени кандидата.
- Проверка готовности. Система не показывает блокеров; предупреждения о непокрытых компетенциях разобраны.
- Пилот. Прогоните тест на 2–3 своих сотрудниках известного уровня и посмотрите отчёты с маршрутами: логика выбора вопросов должна быть объяснима, а итоговые профили — соответствовать вашим ожиданиям об этих людях.
- Интерпретация. Договоритесь, как используется результат: итоговый отчёт — вход для интервью и решения человека, а не замена им.
Заключение
Адаптивное тестирование — это не «AI вместо HR», а способ тратить вопросы туда, где они дают информацию. Кандидат отвечает на 30–40 вопросов вместо 60–100, получает задачи своего уровня и реже бросает тест; вы получаете профиль по компетенциям и объяснимый маршрут вместо одной цифры. LLM-подход снимает главный барьер классического CAT — необходимость месяцами калибровать банк — и при этом остаётся в жёстких рамках: только подготовленный банк, только в пределах лимитов, с проверкой каждого решения кодом.
Но у медали есть обратная сторона, и она — в ваших руках: качество адаптивного теста упирается в качество банка вопросов. Система строит честный маршрут по банку, но не может задать вопрос, которого в банке нет, и не может варьировать сложность, если все вопросы одного уровня. Начните со Сбалансированной стратегии на Стандартной глубине, соберите банк с запасом, прогоните пилот на своих людях — и дальше настраивайте стратегию и глубину под конкретные задачи.
Частые вопросы
Что такое адаптивное тестирование при оценке кандидатов?
Это формат теста, в котором следующий вопрос подбирается по уже данным ответам: система анализирует покрытие компетенций, сложность и правильность ответов и выбирает, что спросить дальше. Сильный кандидат быстрее выходит на сложные вопросы, слабый не «тонет» в непосильных задачах, а тест заканчивается, когда уровень определён достаточно надёжно.
Сколько вопросов нужно в банке для адаптивного теста?
Не меньше максимума выбранной глубины теста: 30 вопросов для Быстрой, 50 для Стандартной и 100 для Углубленной. Комфортный объём — в 1,5–2 раза больше максимума, чтобы системе было из чего выбирать до конца теста. Вопросы стоит распределять равномерно по 5–7 компетенциям с покрытием всех уровней сложности.
Чем адаптивный тест лучше обычного теста с фиксированным набором вопросов?
Фиксированный тест рассчитан на «среднего» кандидата: сильным он скучен, слабым непосилен, а большинство ответов не добавляют информации. Адаптивный тест тратит вопросы туда, где остаётся неопределённость, поэтому оценка получается точнее при меньшем числе вопросов, а кандидаты реже бросают тест на середине.
Может ли AI в адаптивном тесте придумывать собственные вопросы во время тестирования?
Нет. Модель выбирает только из заранее подготовленного и проверенного банка вопросов: сочинить новый вопрос на ходу, задать один вопрос дважды или продлить тест сверх лимита она не может — эти ограничения обеспечивает программный код, а не промпт. Каждый выбор модели логируется вместе с обоснованием.


